
云原生AI算力一体化
▍方案概述
大模型从训练到业务落地,算力是绕不开的投入,而企业普遍面临「三难」:自建 GPU 集群一次性投入动辄数百万,日常利用率却常常不足三成;临时上公有云,又担心与本地数据、已有集群割裂成两套体系、两套账单;AI 项目高峰期算力一卡难求,项目结束后资源又在机房里闲置折旧。
本方案将主流云厂商官方授权的公有云算力与客户本地私有化集群打通,构建统一的算力调度平面:训练与推理负载在同一资源池按需调度,高峰期分钟级弹性扩容补能,峰值过后即释放资源,避免为峰值长期买单;本地集群与公有云统一纳管、统一监控、统一成本视角,一套体系管好全部算力。
算力采购上采用按量与预留相结合的组合策略,配合闲置资源治理,让每一分算力支出都花在刀刃上;长期合作中我们持续输出成本优化建议,账单越用越清晰,算力利用率与交付效率双提升。
▍典型适用场景
场景1 · 大模型训练与推理:训推一体化资源池统一供给,训练与推理负载按需调度:训练任务窗口期独占算力、推理服务常态运行,互不挤占又互为补位,整体算力利用率与交付效率双提升。
场景2 · 算力弹性扩容:AI 项目高峰期分钟级扩容补能,项目结束即释放资源。业务高峰不再排队等算力,低谷不再为闲置买单,算力支出随业务曲线弹性伸缩。
场景3 · 混合云算力调度:本地集群与公有云统一纳管、统一监控、统一成本视角。管理者在一张视图上看清全部算力的运行状态与花费明细,调度决策有据可依。
▍我们的优势
优势1 · 官方算力渠道:作为主流云厂商官方授权销售和咨询伙伴,GPU 资源供给正规、价格透明,供给保障与售后服务有官方体系背书。
优势2 · 弹性调度实践:多个智算类项目交付经验,训推调度与弹性伸缩策略成熟可复用,为企业少走弯路、快速见效。
优势3 · 成本持续优化:按量与预留组合购置建议,配合闲置资源治理,算力支出更精细;长期合作中持续输出成本优化报告。
▍方案架构
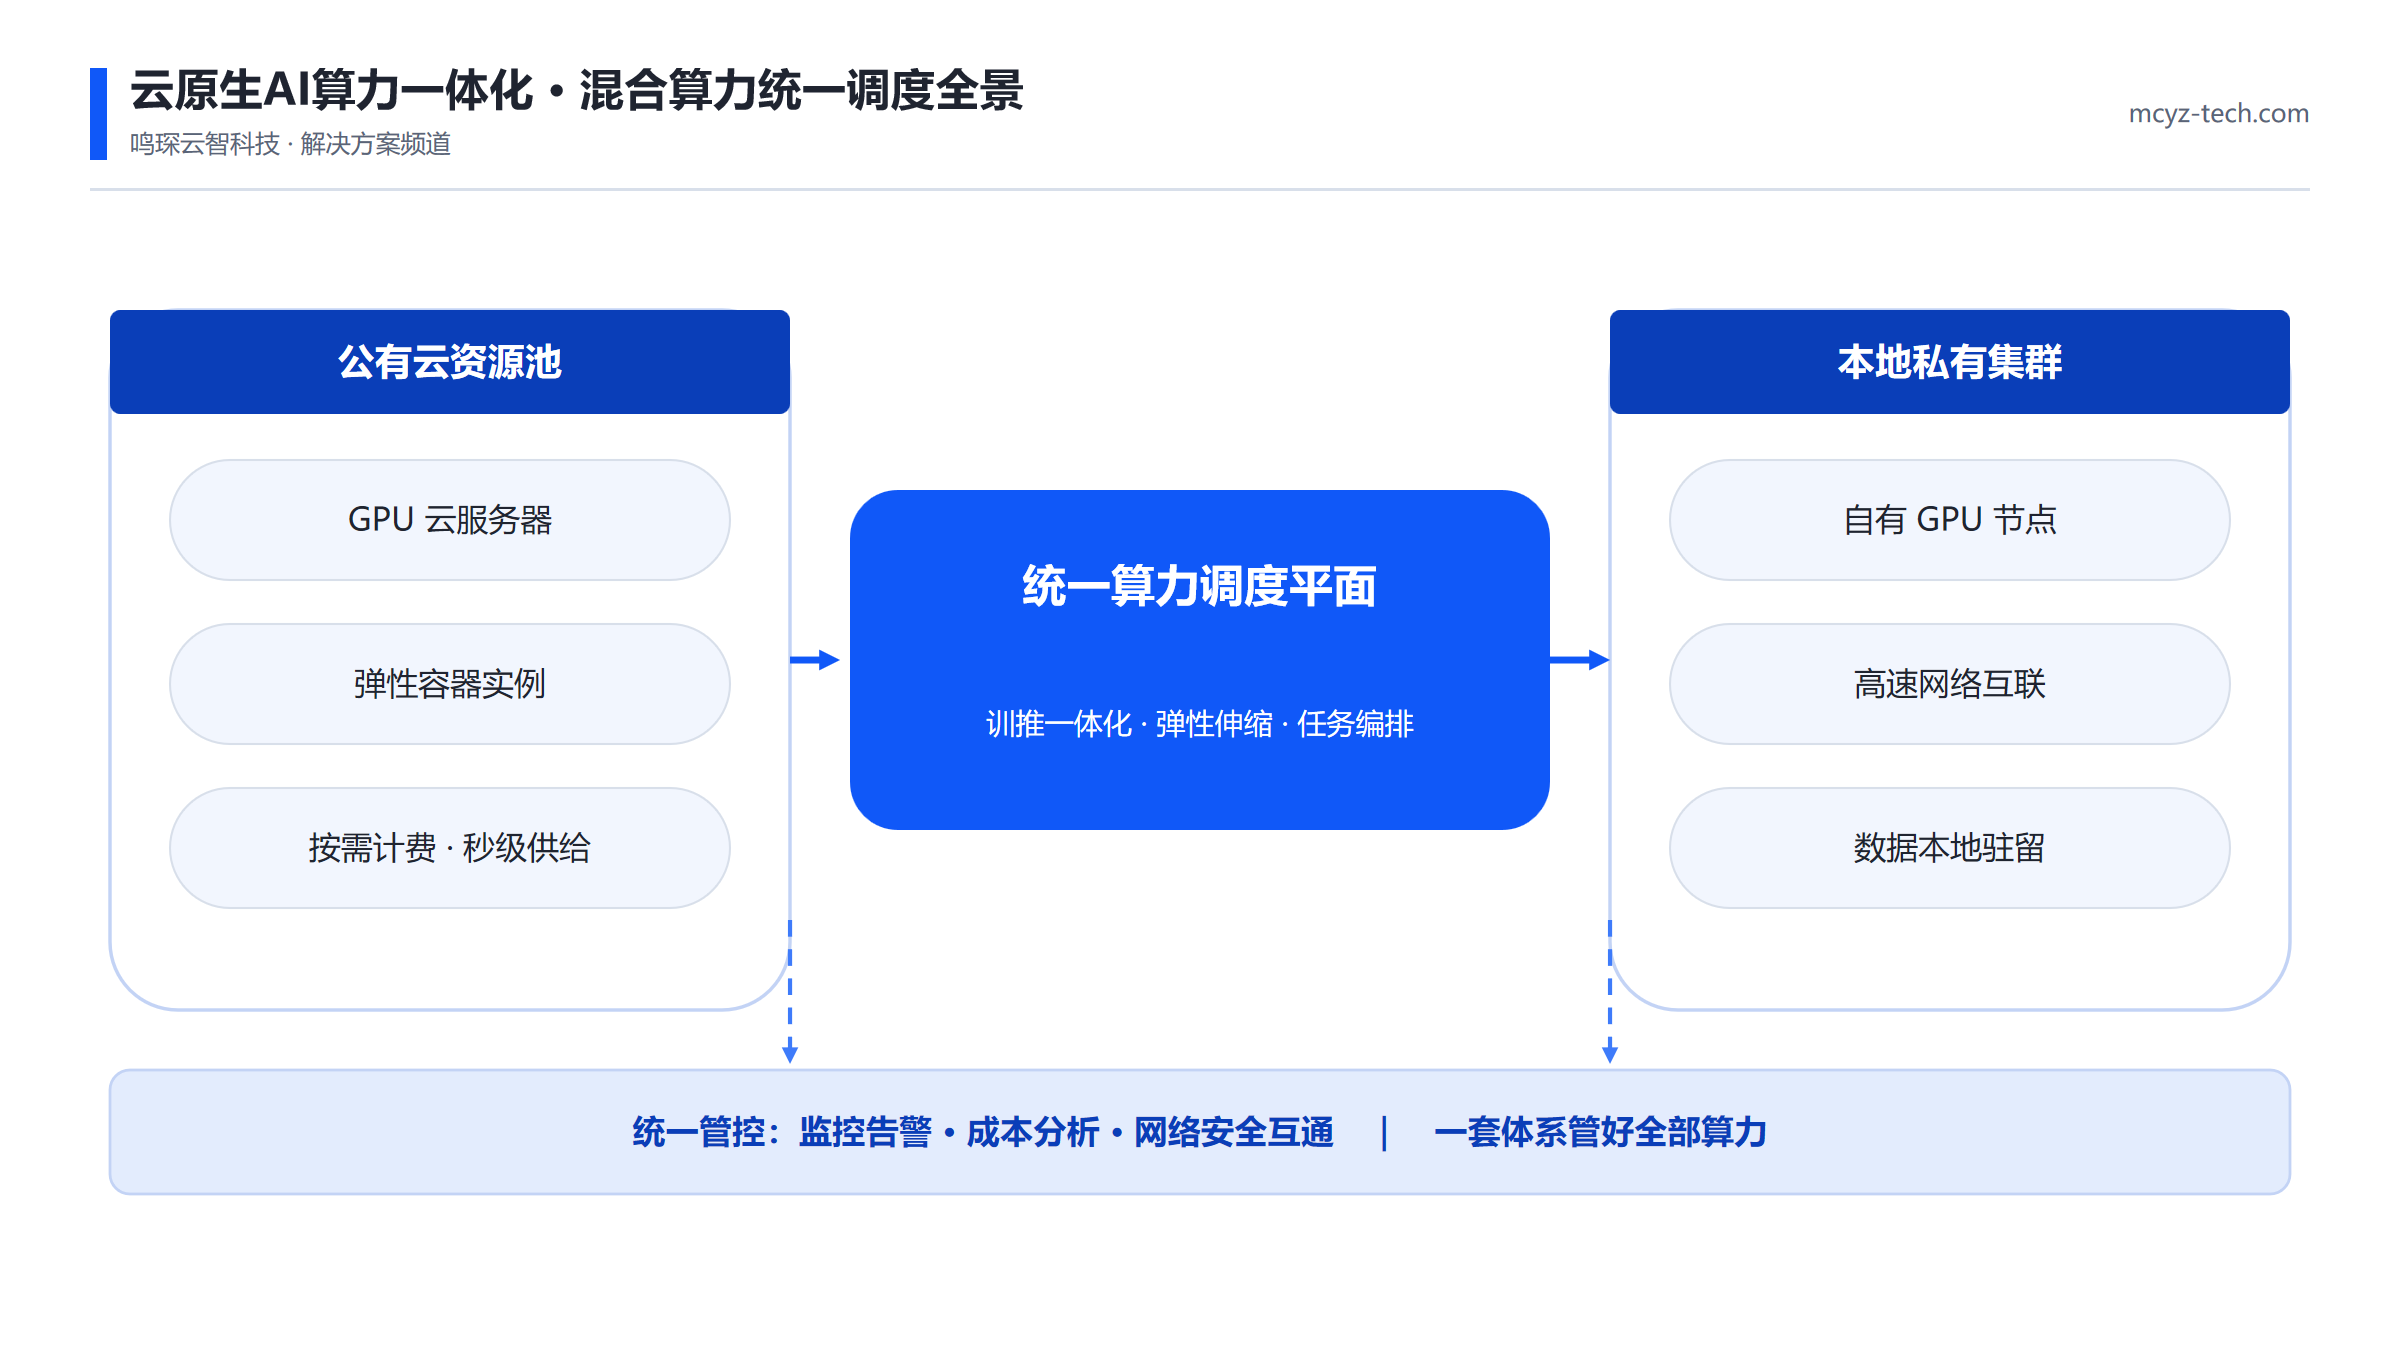
架构图一解读:
这张全景图展示混合算力统一调度的整体结构,分为资源、调度、管控三个视角:
左右两侧是两类算力资源:左侧公有云资源池提供 GPU 云服务器、弹性容器实例,按需计费、秒级供给,适合突发负载与弹性补能;右侧本地私有集群由客户自有 GPU 节点组成,高速网络互联、数据本地驻留,适合常态负载与敏感数据场景。
中间是方案的核心——统一算力调度平面,承担训推一体化调度、弹性伸缩与任务编排:无论算力在公有云还是本地,训练与推理任务都由这一平面统一分配,两边的资源像同一个池子一样使用。
底部是统一管控层:监控告警覆盖全部节点、成本分析统一两边账单、网络安全保障跨环境互联,真正做到「一套体系管好全部算力」。

架构图二解读:
这张时间轴示意图展示训推一体弹性调度的运行方式:横轴是项目周期(T0 项目启动 → T1 训练窗口 → T2 业务高峰 → T3 峰值回落 → T4 常态运行),纵轴是三类算力资源线:
深色的训练窗口线显示,模型微调任务在 T1 至 T3 期间占用大量算力,集中完成训练后释放;蓝色的常态推理线贯穿始终,承载业务系统的日常 AI 请求,构成基线容量;橙色的高峰补能线则显示,在 T2 业务高峰期系统分钟级扩容补能,峰值过后即释放——不为峰值长期买单。
三条线的核心思想是:训练与推理负载在同一资源池按需调度、互为补位,配合组合购置策略与闲置治理,让算力利用率与交付效率双提升,账单随业务曲线伸缩。

